Generative KI im Bildungsbereich hat ein Glaubwürdigkeitsproblem. Lass einen allgemeinen Chatbot eine Fünftklass-Lektion zur Photosynthese schreiben — du bekommst eine selbstbewusste, gut strukturierte Antwort. Etwa 80% sind richtig. Die anderen 20% sind subtil falsch — erfundene Daten, falsch beschriftete Diagramme, fabrizierte Quellen oder Lehrplanstandards, die in deinem Land nicht existieren. In lockerer Schreibarbeit ist das ärgerlich. Im Klassenzimmer ist es echt gefährlich.
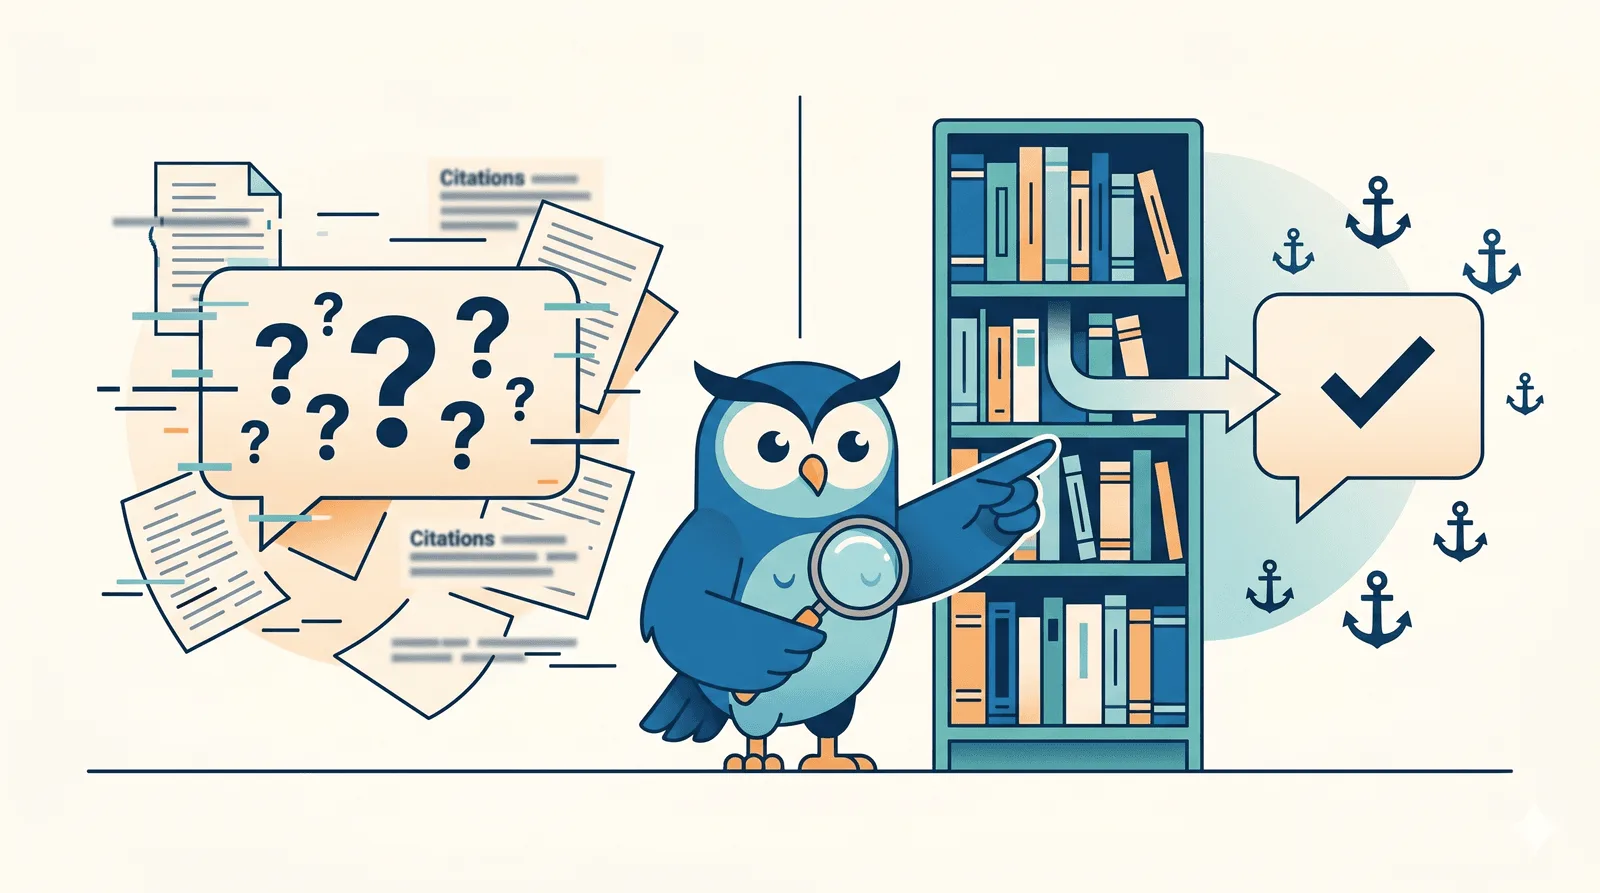
Der Fachbegriff lautet Halluzination und ist die größte Hürde für vertrauenswürdige KI in der Bildung. Die beste Verteidigung ist kein klügeres Modell — sie heißt Verankerung des Modells in geprüftem Wissen. Dieser Artikel erklärt, wie Wissensbasen, Retrieval-Augmented Generation (RAG) und kuratierte Faktenbibliotheken Halluzinationen wirklich reduzieren, warum das für Schulen zählt und wie Samios Smart Engine das umsetzt.
Was ist eine KI-Halluzination?
In der Forschung zur Sprachgenerierung ist eine Halluzination generierter Inhalt, der unsinnig oder dem bereitgestellten Quellinhalt untreu ist (Ji et al., „Survey of Hallucination in Natural Language Generation“, ACM Computing Surveys, 2023). Forschung unterscheidet zwei Arten: intrinsische (Output widerspricht dem Input) und extrinsische (Output erfindet Informationen, die im Input nicht vorkommen, präsentiert sie aber als Tatsache).
Große Sprachmodelle halluzinieren, weil ihr Trainingsziel die Vorhersage des nächsten Tokens ist, nicht faktische Korrektheit. Bei Fragen, deren Antwort im Training nicht gut repräsentiert war, erzeugt das Modell etwas Plausibles, das dem Muster ähnlicher Texte entspricht. Der Output ist flüssig, weil Flüssigkeit optimiert wurde; Wahrheit nicht.
- Eine Quellenangabe erfinden — ein realistisch klingender Paper-Titel, plausible Autor:innen, ein realistisch klingendes Journal, aber das Paper existiert nicht.
- Einen Lehrplanstandard fabrizieren — „Common Core 5.MD.7“ (existiert nicht) als Basis einer Lektion zitieren.
- Ein Zitat falsch zuordnen — eine berühmte Person mit einem Satz verbinden, den sie nie sagte.
- Ein historisches Datum konfabulieren — eine Schlacht auf ein Jahr datieren, das in keiner Quelle vorkommt.
- Falsche, aber selbstbewusste Mathematik — ein Schritt einer Herleitung, der ohne Warnung ein Vorzeichen umdreht.
Warum Halluzination im Bildungsbereich schlimmer ist
Eine halluzinierte Filmempfehlung kostet zehn Sekunden. Ein halluzinierter Lehrplanstandard kostet eine Unterrichtswoche. Der Wirkungsradius eines KI-Fehlers in der Bildung ist einzigartig groß, weil (1) die Empfänger:in ein Kind ist, dem das Vorwissen zur Fehlererkennung fehlt, (2) der Fehler durch Wiederholung und Bewertung verstärkt wird und (3) er sich durch Hausaufgaben, Elternkommunikation und Folge-Lektionen ausbreitet.
Lehrkräfte verschärfen das Problem, wenn sie KI-Tools so vertrauen wie einem Schulbuch. Bücher werden redigiert, von Ministerien lehrplanmäßig abgestimmt und zwischen Auflagen korrigiert. Generischer LLM-Output bietet keine dieser Garantien. Die Literatur ist mittlerweile umfangreich — siehe Chiu, Xia & Chai (2023), „Systematic literature review on opportunities, challenges, and future research recommendations of artificial intelligence in education“, Computers and Education: Artificial Intelligence.
Grounding — die formale Lösung gegen Halluzination
Grounding in NLP bedeutet, KI-Output an verifizierbare externe Quellen zu binden. Das geerdete Modell muss die Antwort nicht in seinen Gewichten „kennen“ — es muss Inhalte aus einem vertrauenswürdigen Korpus abrufen und treu reproduzieren. Das verschiebt die Vertrauensgrenze: Statt einem 70-Milliarden-Parameter-Blob zu vertrauen, vertraust du einer kuratierten Wissensbasis, die du auditieren und aktualisieren kannst.
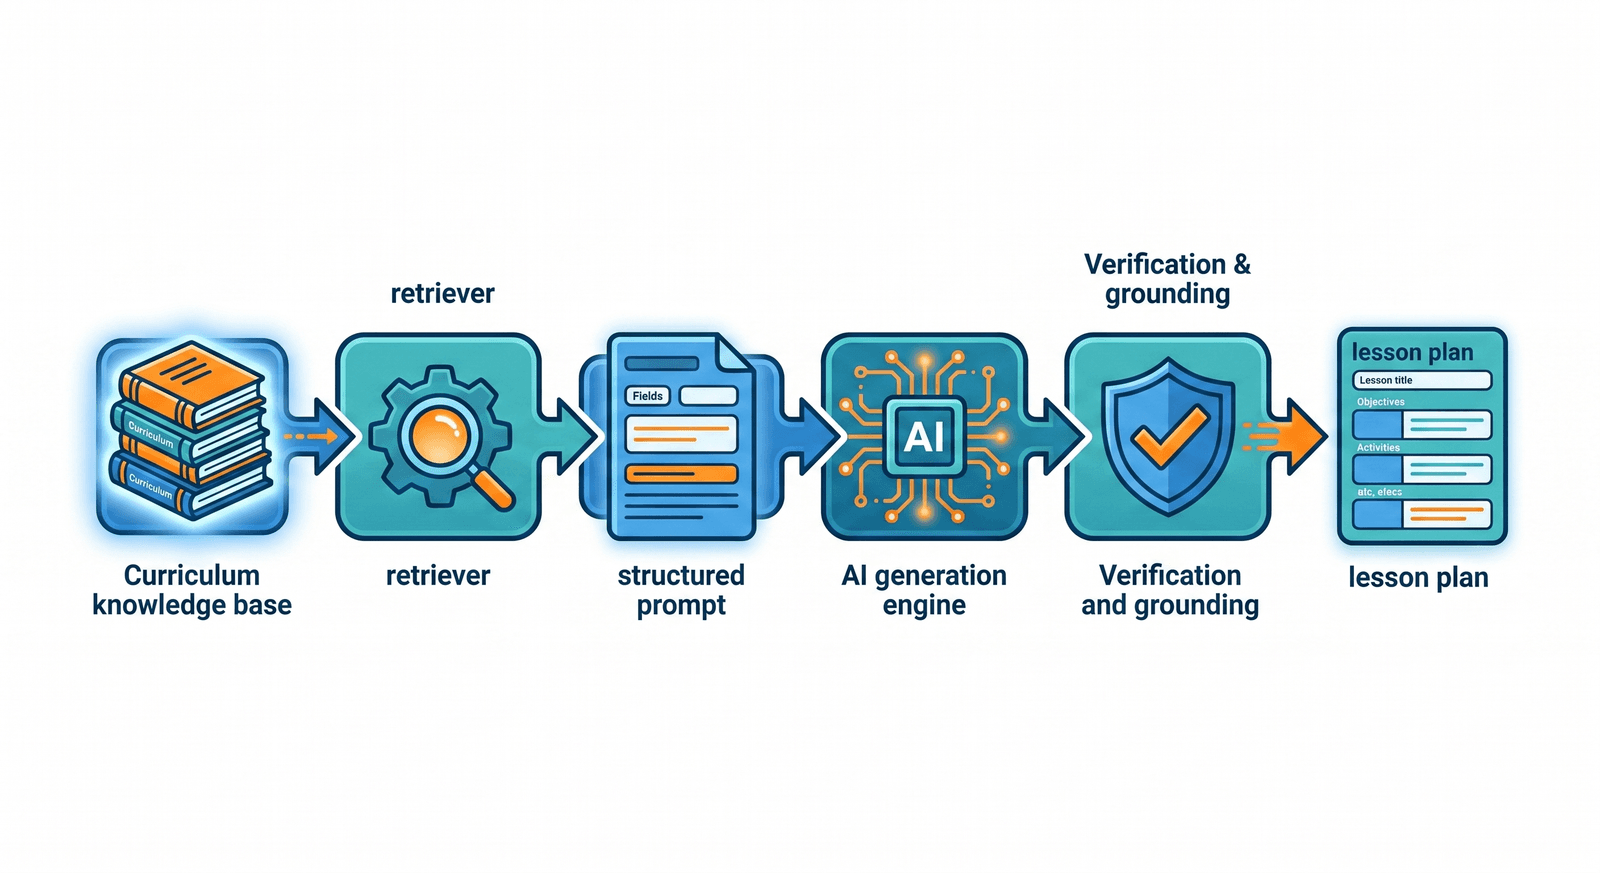
Der einflussreichste Rahmen dafür ist Retrieval-Augmented Generation (RAG), eingeführt in Lewis et al., „Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks“ (NeurIPS 2020). RAG arbeitet zweistufig: Ein Retriever zieht relevante Passagen aus einem Vektorindex vertrauenswürdiger Dokumente, ein Generator konditioniert seinen Output auf diese Passagen. Der Abruf verankert das Modell in verifizierbarem Text; die Generierung passt es an die Anfrage an.
Aktuelle Übersichten (Gao et al., „Retrieval-Augmented Generation for Large Language Models: A Survey“, 2024) zeigen, dass RAG-Systeme die faktische Halluzination um 30–60% in QA-Benchmarks gegenüber gleich großen LLMs ohne RAG reduzieren. Der Gewinn ist am größten in Domänen mit strukturierter, endlicher Grundwahrheit — exakt die Struktur von Lehrplanstandards.
Das Grounding-Toolkit — RAG, Wissensbasen und beschränkte Generierung
Grounding ist ein Schirm für mehrere komplementäre Techniken. Jede adressiert einen anderen Fehlermodus.
Wissensbasen (KBs)
Strukturierte Speicher geprüfter Fakten — Entitäten, Beziehungen, Attribute — typischerweise von Menschen kuratiert und planmäßig aktualisiert.
Wikidata, Wikipedia, nationale Datenbanken für Lehrplanstandards. Samio betreibt eine eigene KB für Standards je Land, Klassenstufe und Fach.
Retrieval-Augmented Generation (RAG)
Relevante Passagen aus einem Vektorindex vertrauenswürdiger Texte abrufen und Output darauf konditionieren.
Verwendet von Bing Chat, Perplexity und den meisten produktiven Assistenten. Reduziert extrinsische Halluzination durch Verankerung in geprüftem Quellmaterial.
Faktenbibliotheken / Templated Content
Vorgeprüfte Aufgaben-Templates, Satzbanken und Lösungsschlüssel, die die KI ausfüllt oder auswählt, statt zu erfinden.
Samio nutzt Faktenbibliothek-gestützte Generierung für Mathe-Textaufgaben, Phonetik und Leseverstehen, wo Lösungsschlüssel deterministisch sein müssen.
Beschränkte Generierung
Ausgabe des Modells auf ein definiertes Schema, Vokabular oder Grammatik einschränken und damit ganze Fehlerklassen eliminieren.
JSON-Modus, regex-beschränkte Decodierung, endliche-Zustands-Output. Wird in Samios Aufgabengenerierung gegen fehlerhafte Outputs eingesetzt.
Verifikationsschichten
Nach-Generierungs-Prüfungen, die Output mit einer Wahrheitsquelle abgleichen und Abweichungen ablehnen oder markieren.
Samio prüft generierte Lehrplan-Zitate gegen die Standardsdatenbank; Mismatches werden vor Erreichen der Lehrkraft abgewiesen.
Wie Samio seine Smart Engine erdet
Samios Smart Engine — das KI-System hinter Jahresplänen, Unterrichtseinheiten, individuellen Aufgaben und Aufgabengenerierung — nutzt alle vier Grounding-Techniken oben. Die Architektur ist bewusst konservativ: Die KI verfasst niemals selbständig Lehrplaninhalt.
Was passiert, wenn eine Lehrkraft Samio um einen Jahresplan für „5. Klasse Mathematik, Niederlande“ bittet:
- Lehrplan-Abruf — Samios Datenbank nationaler Standards (je Land, Klasse, Fach) wird zuerst abgefragt. Standards für „NL, Klasse 5, Mathematik“ werden als strukturierte Datensätze abgerufen, nicht als Freitext.
- Geerdete Prompt — diese strukturierten Standards werden als Wahrheitsquelle in den Prompt eingespeist. Die Aufgabe der KI: organisieren und adaptieren, nicht erfinden, welche Standards existieren.
- Schemabeschränkter Output — der Jahresplan wird gegen ein festes Schema (Woche, Thema, Einheit, Aufgabentypen) generiert. Außerhalb des Schemas kann nichts ausgegeben werden.
- Aufgaben aus der Faktenbibliothek — die konkreten Aufgaben stammen aus vorgeprüften Templates und Wortbänken, abgestimmt auf jeden Standard. Halluzinationsanfällige Teile (Fakten, Vokabellisten, Lösungsschlüssel) sind deterministisch.
- Verifikationsschicht — jeder Plan wird gegen die Standards-DB geprüft. Ein zitierter Standard, der nicht in der Wahrheitsquelle existiert, löst Regenerierung oder Markierung aus.
- Länderspezialisierung — die Engine führt für jedes unterstützte Land eigene KBs, sodass ein „Klasse 5“-Plan in Spanien LOMLOE folgt, nicht Common Core.
So vergleicht sich das mit anderen KI-Tools im Bildungsbereich
Viele KI-Bildungstools sehen oberflächlich gleich aus („wir generieren Lektionspläne!“), unterscheiden sich aber massiv im Grad der Verankerung. Ein ehrlicher Vergleich.
| Feature | Samio | ChatGPT | Khanmigo | MagicSchool |
|---|---|---|---|---|
| Lehrplan-Verankerung | KB nationaler Standards je Land | Keine — beruht auf Trainingsdaten | Khan-Academy-Lehrplan (US-zentriert) | Templates + LLM, teilweise Verankerung |
| Lehrplan je Land | Vollständig — mehrere nationale Lehrpläne | Implizit (Trainingskorpus) | Eingeschränkt (Khan-Inhalte) | Eingeschränkt (US-Standards) |
| Halluzinationsminderung | RAG + Faktenbibliothek + Verifikation | Reines LLM (hohe Halluzination) | RAG über Khan-Inhalte | Templates + leichte Verankerung |
| Quellzitate für Standards | Ja — pro Einheit | Oft halluziniert | Ja (nur Khan) | Manchmal |
| Output-Schema-Erzwingung | Streng (Jahresplan, Lektion, Aufgabe) | Keine | Konversationell | Template-getrieben |
| Sprachen | 7 (Lehrplan + UI) | Viele (ohne Lehrplan-Verankerung) | Englisch (etwas Spanisch) | Englisch zuerst |
| Geeignet für Primar-Lehrplankonformität | Ja | Nein (Verifikation nötig) | Teilweise | Teilweise |
Fazit: „KI für Bildung“ ist keine einzelne Kategorie. Ein geerdetes System mit Lehrplan-Wissensbasis erzeugt ein fundamental anderes Artefakt als ein gepromptelter allgemeiner LLM, auch wenn die UX ähnlich aussieht.
Ehrliche Grenzen — Grounding macht KI nicht unfehlbar
Wir behaupten nicht, Samio sei halluzinationsfrei. Grounding reduziert Halluzinationen drastisch, doch zwei Fehlermodi bleiben: (1) die zugrundeliegende KB kann unvollständig oder veraltet sein, (2) das Modell kann korrekt abgerufenen Inhalt falsch anwenden (z. B. einen Standard der Klasse 4 in einem Plan für Klasse 6 verwenden).
Wir mildern das durch (a) Versionierung der Lehrplan-KB und Bindung jedes Outputs an eine bestimmte KB-Version für Rollback; (b) eine verpflichtende Lehrkräfte-Reviewstufe vor Veröffentlichung an Schüler; (c) Logging jedes Generationsereignisses für nachträgliche Audits; (d) eine interne Evaluationssuite, die die Engine bei jedem KB- oder Modellupdate gegen ein eingefrorenes Set erwarteter Outputs erneut testet. Ziel ist keine perfekte KI, sondern KI, die sicher und sichtbar versagt.
Warum das für Schulen zählt
Für Schulleitungen ist die praktische Implikation einfach: Stellen Sie bei der Bewertung eines KI-Bildungstools drei Fragen. (1) Woher stammt das Lehrplanwissen? (2) Was passiert, wenn das Modell etwas außerhalb seiner geerdeten KB gefragt wird? (3) Kann das System seine Ausgaben zitieren, versionieren und auditieren?
- Lehrplankonformität — generierte Pläne zitieren reale, aktuelle Standards der Bildungsbehörde Ihres Landes, keine erfundenen.
- Auditierbare KI — jede Generierung verweist auf die genutzte KB-Version, Review im Nachhinein möglich.
- Lehrkräfte-Kontrolle — der Human-in-the-Loop-Schritt ist ein Feature, kein Notbehelf.
- Cross-Country-Unterstützung — dieselbe Engine respektiert lokale Lehrpläne, statt überall einen US-zentrierten Blick anzulegen.
- Weniger Nacharbeit — weniger erfundene Fakten im Material bedeutet weniger Aufräumen für Lehrkräfte.
- Verteidigungsfähigkeit — wenn Aufsicht oder Eltern fragen „Woher kommt das?“, gibt es eine Antwort.
Erst Wissen, dann KI
Generative KI ist nicht die Hauptfigur der Bildungstechnologie. Das ist der Lehrplan. Das ist die Wissenschaft, wie Kinder lernen. Das ist die Lehrkraft. KI ist ein mächtiges Werkzeug, dieses Wissen zu organisieren und anzupassen, kann aber nicht seine Quelle sein.
Unsere Wette: Die EdTech-Tools, die den Hype-Zyklus überleben, werden jene sein, die Wissen voranstellen und KI als die disziplinierte Assistentin behandeln, die sie sein sollte. Wir bauen entsprechend.
FAQ
Was ist eine KI-Halluzination?
Von KI generierter Inhalt, der seiner Quelle untreu ist — entweder geprüfter Information widerspricht (intrinsisch) oder Fakten erfindet, die in keiner Quelle stehen (extrinsisch). Der Output ist flüssig und selbstbewusst, aber faktisch falsch.
Was ist RAG und wie reduziert es Halluzinationen?
Retrieval-Augmented Generation: Die KI ruft zuerst relevante Passagen aus einem vertrauenswürdigen Dokumentenspeicher ab und generiert dann darauf konditioniert. Durch die Verankerung in verifizierbarem Text reduziert RAG extrinsische Halluzination um 30–60% gegenüber LLMs ohne RAG (Gao et al., 2024).
Wie verhindert Samio halluzinierte Lehrplanstandards?
Samio ruft offizielle nationale Standards aus eigener Datenbank vor jeder KI-Generierung ab, injiziert sie als strukturierte Datensätze in den Prompt und prüft nach der Generierung alle zitierten Standards gegen die Wahrheitsquelle. Standards, die nicht in der KB existieren, können im Output nicht erscheinen.
Ist geerdete KI dasselbe wie „ChatGPT für Schulen“?
Nein. Ein allgemeines LLM verlässt sich auf seinen Trainingskorpus und produziert selbstbewussten Output auch ohne faktische Basis. Ein geerdetes System ruft aus einer autoritativen KB ab, beschränkt Output auf geprüften Inhalt und weist Zitate zurück, die nicht in der KB sind.
Kann Grounding Halluzinationen vollständig beseitigen?
Nein, aber stark reduzieren und verbleibende Fehler sichtbar und behebbar machen. Samio kombiniert RAG, Faktenbibliotheken, Schemarestriktionen, Verifikationsschichten und einen verpflichtenden Lehrkräfte-Reviewschritt, bevor Output Schüler erreicht.