L'IA générative en éducation a un problème de crédibilité. Demandez à un chatbot généraliste d'écrire une leçon de photosynthèse pour CM2 et vous obtiendrez une réponse confiante et bien structurée. Environ 80% sera correct. Les 20% restants seront subtilement faux : dates inventées, schémas mal étiquetés, sources fabriquées ou référentiels inexistants dans votre pays. En écriture informelle, c'est gênant. En classe, c'est réellement dangereux.
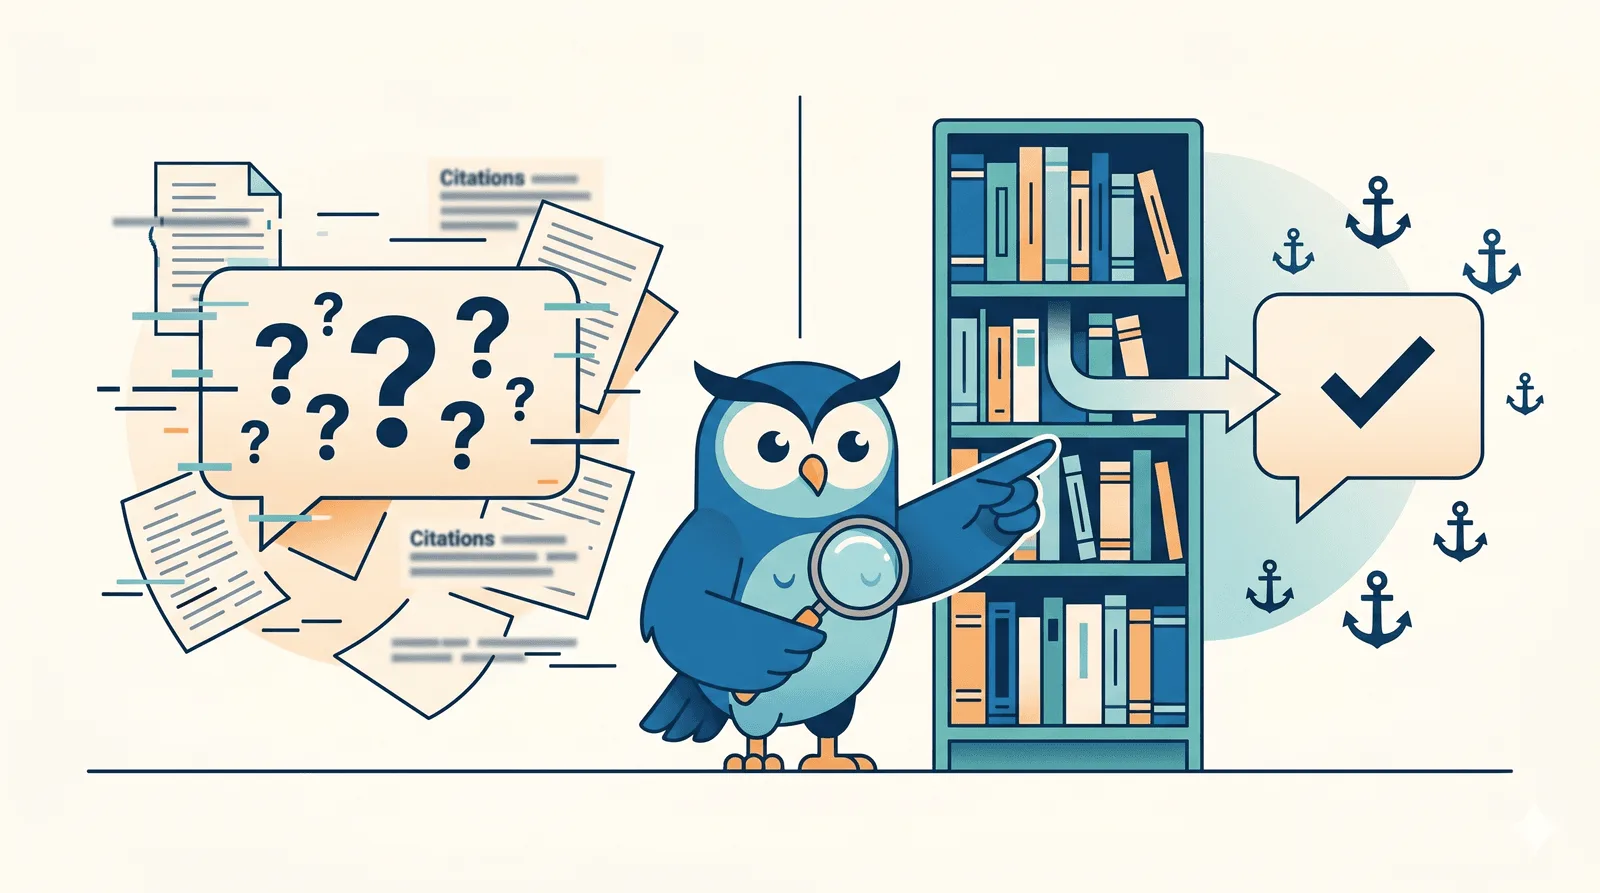
Le terme technique est hallucination, et c'est le plus grand obstacle à une IA digne de confiance en éducation. La meilleure défense n'est pas un modèle plus intelligent — c'est ancrer le modèle dans des connaissances vérifiées. Cet article explique comment les bases de connaissances, la génération augmentée par récupération (RAG) et les bibliothèques curées de faits réduisent les hallucinations, pourquoi cela compte pour les écoles, et comment le Smart Engine de Samio les met en œuvre.
Qu'est-ce qu'une hallucination d'IA ?
Dans la recherche en génération de langage naturel, une hallucination est un contenu généré qui est absurde ou infidèle au contenu source fourni (Ji et al., « Survey of Hallucination in Natural Language Generation », ACM Computing Surveys, 2023). Les chercheurs distinguent deux types : intrinsèques (la sortie contredit l'entrée) et extrinsèques (la sortie fabrique des informations absentes de l'entrée mais présentées comme un fait).
Les grands modèles de langage hallucinent parce que leur objectif d'entraînement est la prédiction du token suivant, pas la justesse factuelle. Quand le modèle rencontre une question dont la réponse n'était pas bien représentée à l'entraînement, il produit quelque chose de plausible qui correspond au motif des textes similaires. La sortie est fluide parce que la fluidité a été optimisée ; la vérité, non.
- Inventer une citation — un titre d'article réaliste, des auteurs qui sonnent réels, une revue réaliste, mais l'article n'existe pas.
- Fabriquer un référentiel — citer comme base d'une leçon « Common Core 5.MD.7 » (qui n'existe pas).
- Mal attribuer une citation — associer une personnalité à une phrase qu'elle n'a jamais dite.
- Confabuler une date historique — situer une bataille à une année qui ne correspond à aucun document.
- Générer des maths fausses mais confiantes — une étape de dérivation qui inverse un signe sans avertissement.
Pourquoi l'hallucination est pire en éducation
Une recommandation de film hallucinée coûte dix secondes. Un référentiel halluciné coûte une semaine d'enseignement. Le rayon d'impact d'une erreur d'IA en éducation est singulièrement grand parce que (1) le destinataire est un enfant qui n'a pas la connaissance préalable pour repérer l'erreur, (2) l'erreur est renforcée par la répétition et l'évaluation, et (3) elle se propage aux devoirs, à la communication aux parents et aux leçons suivantes.
Les enseignants aggravent le problème quand ils font confiance aux outils d'IA comme à un manuel. Les manuels sont relus par des éditeurs, alignés sur les programmes par les ministères et corrigés entre éditions. Les sorties d'un LLM générique n'ont aucune de ces garanties. La littérature sur ce risque est désormais conséquente — voir Chiu, Xia & Chai (2023), « Systematic literature review on opportunities, challenges, and future research recommendations of artificial intelligence in education », Computers and Education: Artificial Intelligence.
L'ancrage — la solution formelle à l'hallucination
L'ancrage en TAL signifie lier la sortie d'une IA à des sources externes vérifiables. Le modèle ancré n'a pas à « connaître » la réponse dans ses poids — il doit récupérer et reproduire fidèlement le contenu d'un corpus de confiance. Cela déplace la frontière de confiance : au lieu de faire confiance à un blob de 70 milliards de paramètres, vous faites confiance à une base de connaissances curée que vous pouvez auditer et mettre à jour.
Le cadre le plus influent est Retrieval-Augmented Generation (RAG), introduit dans Lewis et al., « Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks » (NeurIPS 2020). RAG fonctionne en deux étapes : un récupérateur extrait des passages pertinents d'un index vectoriel de documents fiables, et un générateur conditionne sa sortie sur ces passages. L'étape de récupération ancre le modèle dans un texte vérifiable ; l'étape de génération adapte celui-ci à la requête.
Des revues récentes (Gao et al., « Retrieval-Augmented Generation for Large Language Models: A Survey », 2024) montrent que les systèmes RAG réduisent l'hallucination factuelle de 30 à 60 % sur les benchmarks QA par rapport aux LLM utilisés seulement par prompt et de taille égale. Le gain est maximal dans les domaines à vérité structurée et finie — la structure exacte des référentiels.
La trousse d'ancrage — RAG, bases de connaissances et génération contrainte
L'ancrage est un parapluie pour plusieurs techniques complémentaires. Chacune traite un mode d'échec différent.
Bases de connaissances (KB)
Magasins structurés de faits vérifiés — entités, relations, attributs — généralement curés par des humains et mis à jour selon un calendrier.
Wikidata, Wikipédia, bases nationales de référentiels. Samio maintient sa propre KB de référentiels par pays, niveau et matière.
Génération augmentée par récupération (RAG)
Récupérer les passages pertinents d'un index vectoriel de texte de confiance, puis générer la sortie conditionnée sur ces passages.
Utilisée par Bing Chat, Perplexity et la plupart des assistants en production. Réduit l'hallucination extrinsèque en assurant l'ancrage dans des sources vérifiables.
Bibliothèques de faits / contenus modélisés
Modèles d'exercices, banques de phrases et corrigés pré-validés que l'IA remplit ou sélectionne plutôt qu'inventer.
Samio utilise une génération guidée par bibliothèque de faits pour les problèmes de maths, la phonétique et la compréhension où les corrigés doivent être déterministes.
Génération contrainte
Restreindre la sortie du modèle à un schéma, vocabulaire ou grammaire défini, éliminant des classes entières d'erreur.
Mode JSON, décodage contraint par regex, sortie à états finis. Utilisée dans la génération d'exercices Samio pour empêcher les sorties malformées.
Couches de vérification
Contrôles post-génération qui comparent la sortie de l'IA à une source de vérité et rejettent ou signalent les écarts.
Samio recoupe les citations curriculaires générées avec la base de référentiels ; les écarts sont rejetés avant d'atteindre l'enseignant.
Comment Samio ancre son Smart Engine
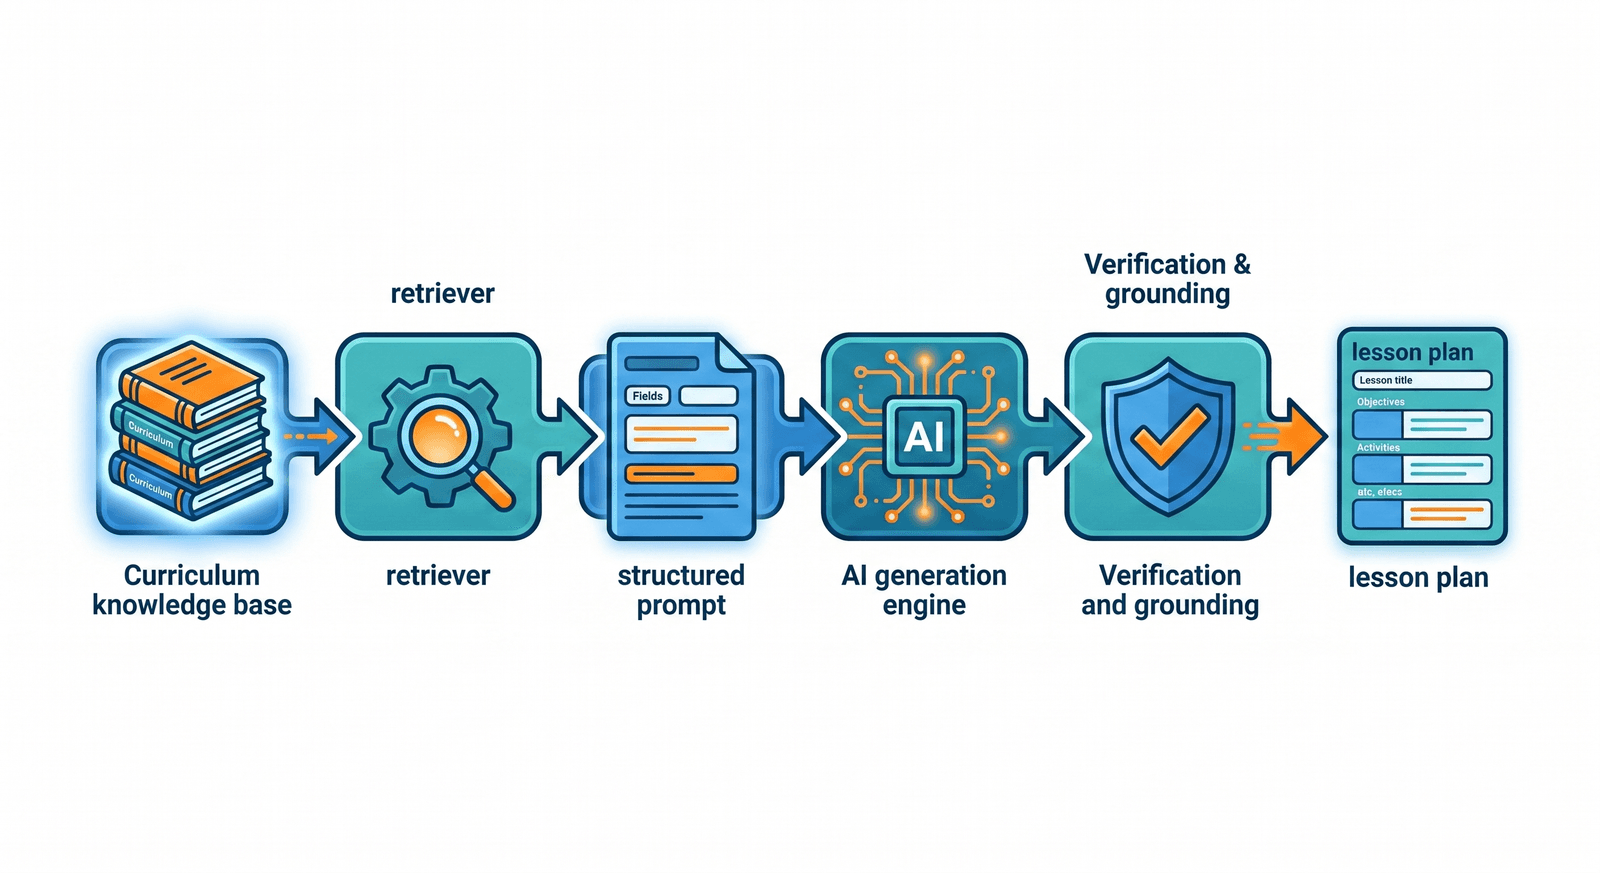
Le Smart Engine de Samio — le système d'IA derrière les plans annuels, les unités de cours, les défis personnalisés et la génération d'exercices — utilise les quatre techniques d'ancrage ci-dessus. L'architecture est délibérément conservatrice : l'IA n'écrit jamais le programme par elle-même.
Voici ce qui se passe quand un enseignant demande à Samio un plan annuel pour « CM2 mathématiques, Pays-Bas » :
- Récupération curriculaire — la base des référentiels nationaux (par pays, niveau, matière) est interrogée d'abord. Les référentiels pour « NL, niveau CM2, mathématiques » sont récupérés en tant qu'enregistrements structurés, pas en texte libre.
- Prompt ancré — ces référentiels structurés sont injectés dans le prompt comme source de vérité. Le rôle de l'IA est de les organiser et de les adapter, pas d'inventer ceux qui existent.
- Sortie contrainte par schéma — le plan annuel est généré contre un schéma fixe (semaine, thème, unité, types d'exercices). Le modèle ne peut pas produire de champs hors schéma.
- Exercices issus de la bibliothèque de faits — les exercices proviennent de modèles et banques de mots pré-validés alignés sur chaque référentiel. Les parties à risque (faits, vocabulaire, corrigés) sont déterministes.
- Couche de vérification — chaque plan est confronté à la base de référentiels. Tout référentiel cité absent de la source de vérité déclenche une régénération ou un signalement.
- Spécialisation par pays — le moteur porte des KB séparées pour chaque pays soutenu, donc un plan « niveau 5 » en Espagne reflète LOMLOE, pas Common Core.
Comment cela se compare aux autres outils d'IA en éducation
Beaucoup d'outils d'IA pédagogique se ressemblent en surface (« nous générons des plans ! ») mais diffèrent énormément par le degré d'ancrage de leur sortie. Comparaison honnête.
| Feature | Samio | ChatGPT | Khanmigo | MagicSchool |
|---|---|---|---|---|
| Ancrage curriculaire | KB de référentiels nationaux par pays | Aucun — repose sur les données d'entraînement | Programme Khan Academy (centré USA) | Modèles + LLM, ancrage partiel |
| Programme par pays | Complet — multiples programmes nationaux | Implicite (corpus d'entraînement) | Limité (contenu Khan) | Limité (référentiels USA) |
| Atténuation des hallucinations | RAG + bibliothèque de faits + vérification | LLM brut (forte hallucination) | RAG sur le contenu Khan | Modèles + ancrage léger |
| Citation des référentiels | Oui — par unité | Souvent hallucinée | Oui (Khan uniquement) | Parfois |
| Schéma de sortie imposé | Strict (plan, leçon, exercice) | Aucun | Conversationnel | Modèles |
| Langues | 7 (programme + UI) | Beaucoup (sans ancrage curriculaire) | Anglais (un peu d'espagnol) | Anglais d'abord |
| Adapté à la conformité curriculaire primaire | Oui | Non (vérification requise) | Partiel | Partiel |
À retenir : « IA pour l'éducation » n'est pas une catégorie unique. Un système ancré avec base de connaissances curriculaire produit un artefact fondamentalement différent d'un LLM général prompté, même si l'UX se ressemble.
Limites honnêtes — l'ancrage ne rend pas l'IA infaillible
Nous ne prétendons pas que Samio est sans hallucination. L'ancrage les réduit considérablement, mais deux modes d'échec subsistent : (1) la base sous-jacente peut être incomplète ou périmée, et (2) le modèle peut mal utiliser un contenu correctement récupéré (par exemple appliquer un référentiel CM1 à un plan CM2).
Nous atténuons cela par (a) le versionnement de la KB et le rattachement de chaque sortie à une version précise pour pouvoir revenir en arrière ; (b) une étape de revue par l'enseignant avant que toute sortie n'aille aux élèves ; (c) la journalisation de chaque génération pour audit a posteriori ; (d) une suite d'évaluation interne qui retest le moteur contre un jeu figé de sorties attendues à chaque mise à jour de la KB ou du modèle. L'objectif n'est pas une IA parfaite, mais une IA qui échoue de façon sûre et visible.
Pourquoi cela compte pour les écoles
Pour un chef d'établissement, l'implication pratique est simple : posez trois questions quand vous évaluez un outil d'IA pédagogique. (1) D'où vient la connaissance curriculaire ? (2) Que se passe-t-il quand on demande au modèle quelque chose hors de sa KB ancrée ? (3) Le système peut-il citer, versionner et auditer ses sorties ?
- Conformité curriculaire — les plans générés citent des référentiels réels et à jour de l'autorité éducative de votre pays, non inventés.
- IA auditable — chaque génération référence la version de KB utilisée, rendant la revue a posteriori possible.
- Contrôle enseignant — l'étape de revue humaine est une fonctionnalité, pas un palliatif.
- Soutien multi-pays — le même moteur respecte les programmes locaux au lieu d'imposer une lecture US partout.
- Moins de remédiation — moins de faits inventés signifie moins de nettoyage par l'enseignant.
- Défendabilité — quand un régulateur ou un parent demande « d'où ça vient ? », il y a une réponse.
La connaissance d'abord, l'IA ensuite
L'IA générative n'est pas le protagoniste de la technologie éducative. Le programme l'est. La science de l'apprentissage des enfants l'est. L'enseignant l'est. L'IA est un outil puissant pour organiser et adapter cette connaissance, mais elle ne peut pas en être la source.
Notre pari : les outils EdTech qui survivront à la hype seront ceux qui mettent la connaissance d'abord et traitent l'IA comme l'assistante disciplinée qu'elle doit être. Nous construisons en conséquence.
FAQ
Qu'est-ce qu'une hallucination d'IA ?
Un contenu généré par IA infidèle à sa source — soit contredisant des informations vérifiées (intrinsèque), soit inventant des faits absents de toute source (extrinsèque). La sortie est fluide et confiante, mais factuellement fausse.
Qu'est-ce que RAG, et comment réduit-il les hallucinations ?
Retrieval-Augmented Generation : l'IA récupère d'abord des passages pertinents dans un magasin de documents fiables, puis génère la sortie conditionnée sur ces passages. En ancrant la génération dans du texte vérifiable, RAG réduit l'hallucination extrinsèque de 30 à 60 % par rapport aux LLM uniquement promptés (Gao et al., 2024).
Comment Samio empêche-t-il les référentiels hallucinés ?
Samio récupère les référentiels nationaux officiels de sa propre base avant toute génération, les injecte dans le prompt en tant qu'enregistrements structurés et vérifie après génération toutes les citations contre la source de vérité. Les référentiels absents de la KB ne peuvent apparaître dans la sortie.
L'IA ancrée est-elle pareille que « ChatGPT pour les écoles » ?
Non. Un LLM général repose sur son corpus d'entraînement et produit des sorties confiantes même sans base factuelle. Un système ancré récupère depuis une KB autoritative, contraint la sortie au contenu vérifié et rejette les citations absentes de la KB.
L'ancrage peut-il éliminer entièrement les hallucinations ?
Non, mais il les réduit fortement et rend les erreurs restantes visibles et récupérables. Samio combine RAG, bibliothèques de faits, contraintes de schéma, couches de vérification et une étape obligatoire de revue par l'enseignant avant que la sortie n'atteigne les élèves.