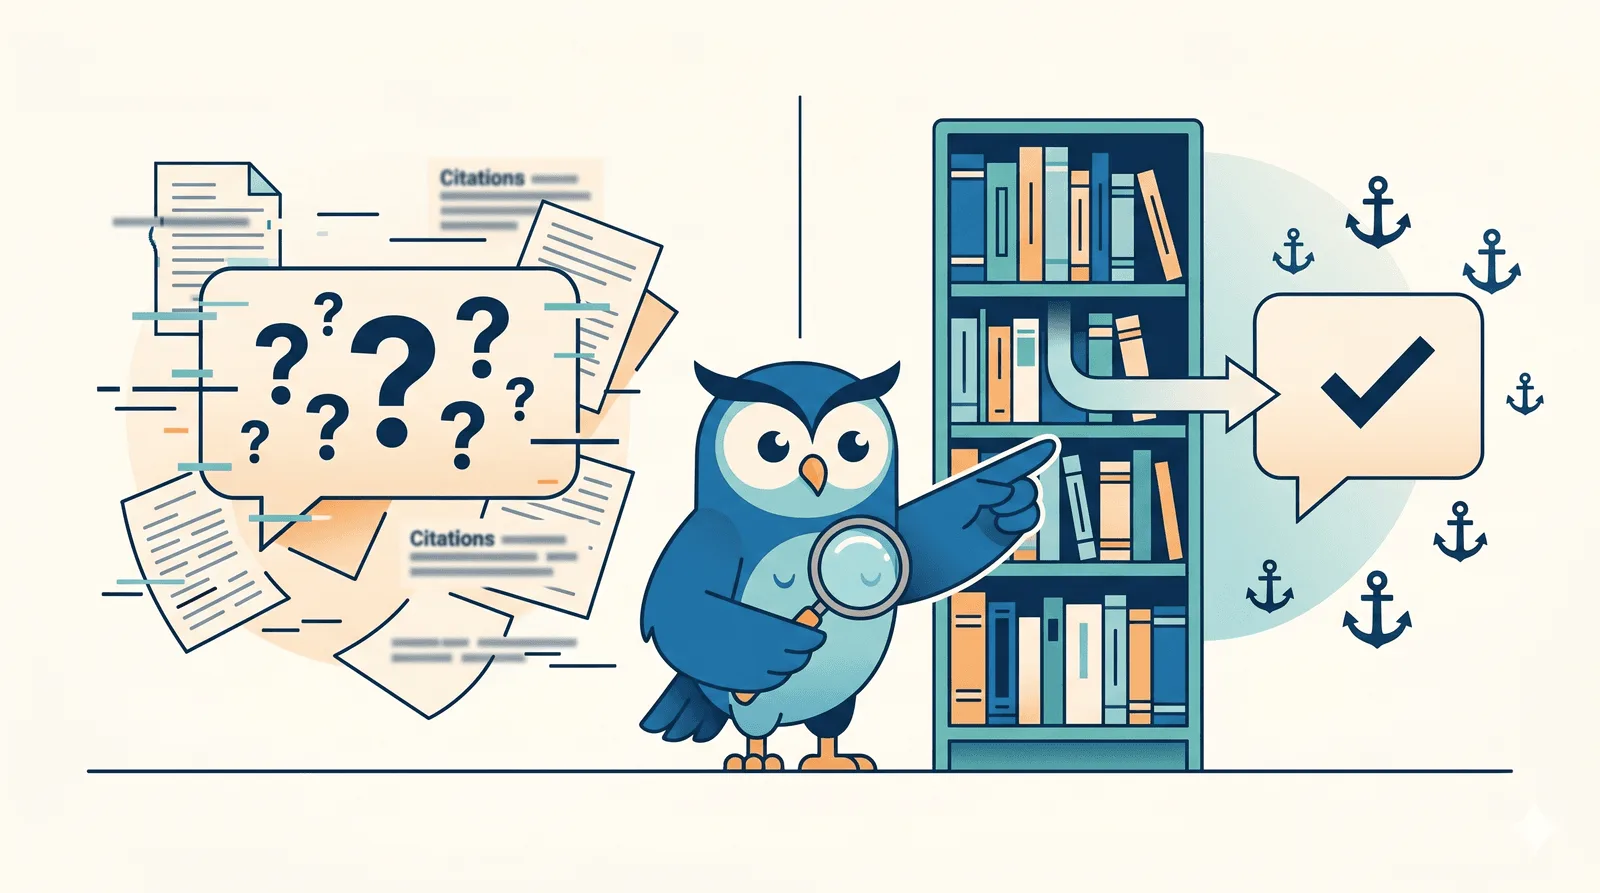
La IA generativa en educación tiene un problema de credibilidad. Pídele a un chatbot generalista que escriba una lección de fotosíntesis para 5.º grado y tendrás una respuesta confiada y bien estructurada. Cerca del 80% será correcto. El otro 20% será sutilmente erróneo: fechas inventadas, diagramas mal etiquetados, fuentes inexistentes o estándares curriculares que no existen en tu país. En la escritura informal eso molesta. En el aula, es genuinamente peligroso.
El nombre técnico es alucinación, y es el mayor obstáculo para una IA confiable en educación. La mejor defensa no es un modelo más inteligente: es anclar el modelo en conocimiento verificado. Este artículo explica cómo las bases de conocimiento, la generación aumentada por recuperación (RAG) y las bibliotecas curadas de hechos reducen realmente las alucinaciones, por qué importan en las escuelas y cómo el Smart Engine de Samio las implementa.
¿Qué es una alucinación de IA?
En la investigación de generación de lenguaje natural, una alucinación es contenido generado que es incoherente o infiel respecto a la fuente proporcionada (Ji et al., «Survey of Hallucination in Natural Language Generation», ACM Computing Surveys, 2023). Se distinguen dos tipos: intrínsecas (la salida contradice la entrada) y extrínsecas (la salida inventa información que no estaba en la entrada pero la presenta como hecho).
Los grandes modelos de lenguaje alucinan porque su objetivo de entrenamiento es predecir el siguiente token, no ser correctos. Cuando el modelo se enfrenta a una pregunta cuya respuesta no estaba bien representada en el entrenamiento, produce algo plausible que encaja con el patrón de textos similares. La salida es fluida porque la fluidez es lo que se optimizó; la verdad no.
- Inventar una cita — un título de paper realista, autores que suenan reales, una revista realista, pero el paper no existe.
- Fabricar un estándar curricular — citar como base de una lección «Common Core 5.MD.7» (que no existe).
- Atribuir mal una cita — emparejar a una persona famosa con una frase que nunca dijo.
- Inventar una fecha histórica — datar una batalla en un año que no coincide con ningún registro.
- Generar matemáticas erróneas pero confiadas — un paso de derivación que cambia un signo sin advertencia.
Por qué la alucinación es peor en educación
Una recomendación de película alucinada cuesta diez segundos. Un estándar curricular alucinado cuesta una semana de enseñanza. El radio de impacto de un error de IA en educación es especialmente grande porque (1) quien la recibe es un niño que carece del conocimiento previo para detectar el error, (2) el error se refuerza con la repetición y la evaluación y (3) se propaga a las tareas, la comunicación con familias y las lecciones siguientes.
Los docentes agravan el problema cuando confían en herramientas de IA como en un libro de texto. Los libros pasan por edición, son alineados con el currículo por los ministerios y se corrigen entre ediciones. Las salidas de un LLM genérico no tienen esas garantías. La literatura sobre el tema ya es amplia — véase Chiu, Xia y Chai (2023), «Systematic literature review on opportunities, challenges, and future research recommendations of artificial intelligence in education», Computers and Education: Artificial Intelligence.
Grounding: la solución formal a la alucinación
Grounding (anclaje) en PLN significa atar la salida de la IA a fuentes externas verificables. El modelo anclado no necesita saber la respuesta en sus pesos: necesita recuperar y reproducir fielmente el contenido de un corpus confiable. Eso traslada la frontera de confianza: en vez de confiar en un blob de 70.000 millones de parámetros, confías en una base de conocimiento curada, auditable y actualizable.
El marco más influyente es Retrieval-Augmented Generation (RAG), presentado en Lewis et al., «Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks» (NeurIPS 2020). RAG funciona en dos etapas: un recuperador extrae pasajes relevantes de un índice vectorial de documentos fiables, y un generador condiciona su salida en esos pasajes. La recuperación ancla el modelo en texto verificable; la generación lo adapta a la petición.
Encuestas recientes (Gao et al., «Retrieval-Augmented Generation for Large Language Models: A Survey», 2024) muestran que los sistemas con RAG reducen las alucinaciones factuales un 30–60% en benchmarks de QA frente a los LLM solo con prompt del mismo tamaño. La mejora es mayor en dominios con verdad estructurada y finita — justo la estructura de los estándares curriculares.
El kit de herramientas de grounding — RAG, KBs y generación restringida
Grounding es un paraguas para varias técnicas complementarias. Cada una aborda un modo de fallo distinto.
Bases de conocimiento (KBs)
Almacenes estructurados de hechos verificados — entidades, relaciones, atributos — usualmente curados por humanos y actualizados regularmente.
Wikidata, Wikipedia, bases nacionales de estándares curriculares. Samio mantiene su propia KB de estándares por país, grado y materia.
Generación aumentada por recuperación (RAG)
Recupera pasajes relevantes desde un índice vectorial de texto confiable y luego genera la salida condicionada a esos pasajes.
La usan Bing Chat, Perplexity y la mayoría de asistentes en producción. Reduce alucinaciones extrínsecas al apoyar la salida en material fuente anclado.
Bibliotecas de hechos / contenido por plantilla
Plantillas de ejercicios, bancos de frases y claves de respuesta previamente revisadas, que la IA rellena o selecciona en lugar de inventar.
Samio usa generación basada en bibliotecas de hechos para problemas de matemáticas, fonética y comprensión lectora donde las claves deben ser deterministas.
Generación restringida
Restringe la salida del modelo a un esquema, vocabulario o gramática, eliminando clases enteras de error.
Modo JSON, decodificación restringida por regex, salida de estado finito. Usada en la generación de ejercicios de Samio para evitar salidas malformadas.
Capas de verificación
Comprobaciones posteriores a la generación que comparan la salida con una fuente de verdad y rechazan o marcan los desajustes.
Samio coteja las citas curriculares generadas con la base de estándares; los desajustes se rechazan antes de llegar al docente.
Cómo Samio ancla su Smart Engine
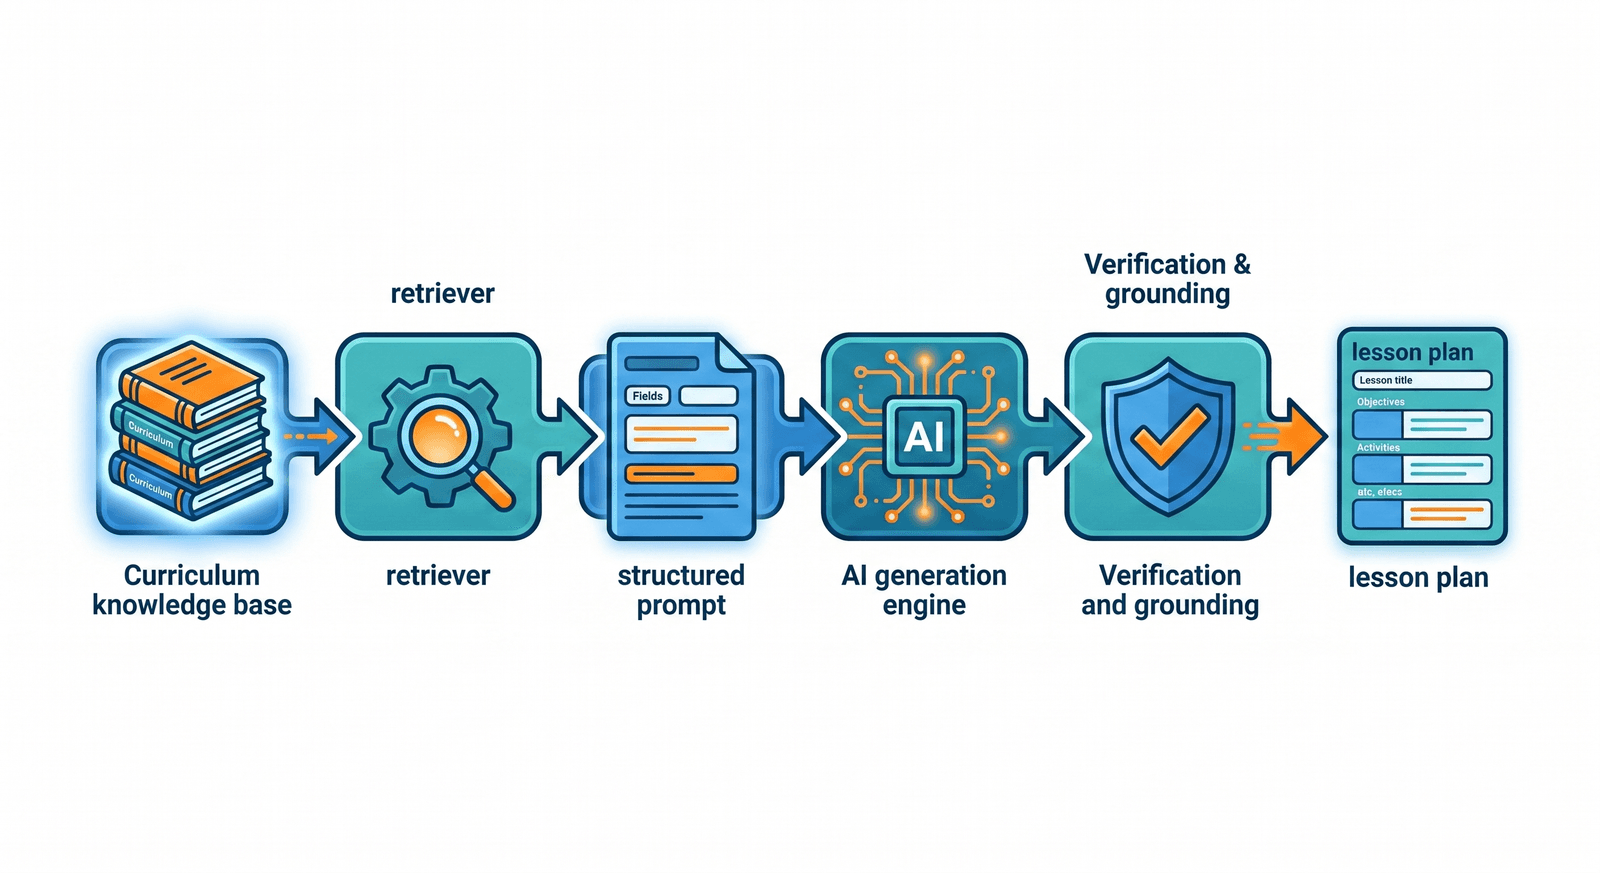
El Smart Engine de Samio — el sistema de IA detrás de los planes anuales, las unidades, los retos personalizados y los ejercicios — usa las cuatro técnicas de grounding anteriores. La arquitectura es deliberadamente conservadora: la IA nunca redacta currículo por su cuenta.
Esto sucede cuando un docente le pide a Samio un plan anual para «5.º grado de matemáticas, Países Bajos»:
- Recuperación curricular — primero se consulta la base de estándares nacionales (por país, grado y materia). Los estándares para «NL, grado 5, matemáticas» se recuperan como registros estructurados, no como texto libre que el modelo deba interpretar.
- Prompt anclado — esos estándares estructurados se inyectan en el prompt como fuente de verdad. La tarea de la IA es organizarlos y adaptarlos a un plan anual, no inventar qué estándares existen.
- Salida con esquema restringido — el plan anual se genera contra un esquema fijo (semana, tema, unidad, tipos de ejercicio). El modelo no puede emitir campos fuera del esquema.
- Ejercicios desde la biblioteca de hechos — los ejercicios concretos se construyen desde plantillas y bancos de palabras revisados, alineados a cada estándar. Las partes propensas a alucinación (datos, vocabulario, claves) son deterministas.
- Capa de verificación — cada plan se contrasta con la base de estándares. Cualquier estándar citado que no exista en la fuente de verdad dispara una regeneración o se marca para revisión.
- Especialización por país — el motor lleva KBs separadas por cada país soportado, así un plan «grado 5» en España refleja LOMLOE, no Common Core.
Cómo se compara con otras herramientas de IA en educación
Muchas herramientas de IA educativa se parecen en superficie («¡generamos planes!») pero difieren enormemente en cuán anclada está su salida. Comparación honesta.
| Feature | Samio | ChatGPT | Khanmigo | MagicSchool |
|---|---|---|---|---|
| Anclaje al currículo | KB de estándares nacionales por país | Ninguno — depende de los datos de entrenamiento | Currículo Khan Academy (centrado en EE. UU.) | Plantillas + LLM, anclaje parcial |
| Soporte por país del currículo | Completo — múltiples currículos nacionales | Implícito (corpus de entrenamiento) | Limitado (contenido Khan) | Limitado (estándares EE. UU.) |
| Mitigación de alucinaciones | RAG + biblioteca de hechos + verificación | LLM puro (alucinación alta) | RAG sobre contenido Khan | Plantillas + anclaje ligero |
| Citación de estándares | Sí — citados por unidad | A menudo alucinados | Sí (solo Khan) | A veces |
| Esquema de salida | Estricto (plan, lección, ejercicio) | Ninguno | Conversacional | Por plantillas |
| Idiomas | 7 (currículo + UI) | Muchos (sin anclaje curricular) | Inglés (algo de español) | Inglés primero |
| Apto para conformidad curricular en primaria | Sí | No (requiere verificación) | Parcial | Parcial |
Conclusión: «IA para educación» no es una sola categoría. Un sistema anclado con base de conocimiento curricular produce un artefacto radicalmente distinto al de un LLM general por prompt, aunque la UX sea parecida.
Límites honestos: el grounding no hace infalible a la IA
No afirmamos que Samio esté libre de alucinaciones. El grounding las reduce mucho, pero quedan dos modos de fallo: (1) la propia base puede estar incompleta o desactualizada, y (2) el modelo puede usar mal contenido correctamente recuperado (por ejemplo, aplicar un estándar de 4.º a un plan de 6.º).
Lo mitigamos así: (a) versionando la KB y atando cada salida a una versión específica para poder revertir; (b) un paso obligatorio de revisión por docente antes de publicar a los estudiantes; (c) registrando cada evento de generación para auditoría a posteriori; (d) ejecutando una suite de evaluación interna que vuelve a probar el motor contra un conjunto congelado de salidas esperadas cada vez que cambia la KB o el modelo. El objetivo no es una IA perfecta, sino una IA que falla de forma segura y visible.
Por qué importa para las escuelas
Para los administradores escolares la implicación práctica es simple: al evaluar una herramienta de IA educativa, hazte tres preguntas. (1) ¿De dónde viene el conocimiento curricular? (2) ¿Qué pasa si se le pide algo fuera de su base anclada? (3) ¿Puede el sistema citar, versionar y auditar su salida?
- Cumplimiento curricular — los planes citan estándares reales y vigentes de la autoridad educativa de tu país, no inventados.
- IA auditable — cada generación referencia la versión de KB usada, permitiendo revisión a posteriori.
- Control docente — el paso de revisión humana es una característica, no un parche.
- Soporte multipaís — el mismo motor respeta los currículos locales en lugar de imponer una mirada estadounidense.
- Menos trabajo de remediación — menos hechos inventados significa menos limpieza por el docente.
- Defensibilidad — cuando un regulador o una familia pregunta «¿de dónde sale esto?», hay respuesta.
Primero el conocimiento, luego la IA
La IA generativa no es la protagonista de la tecnología educativa. Lo es el currículo. Lo es la ciencia de cómo aprenden los niños. Lo es el docente. La IA es una herramienta poderosa para organizar y adaptar ese conocimiento, pero no puede ser su fuente.
La apuesta de Samio es que las herramientas EdTech que sobrevivan al ciclo de hype serán las que pongan el conocimiento primero y traten a la IA como el asistente disciplinado que debe ser. Construimos en consecuencia.
FAQ
¿Qué es una alucinación de IA?
Es contenido generado por IA que no es fiel a su fuente: contradice información verificada (intrínseca) o inventa hechos no presentes en ninguna fuente (extrínseca). La salida es fluida y confiada, pero factualmente incorrecta.
¿Qué es RAG y cómo reduce las alucinaciones?
Retrieval-Augmented Generation es una técnica donde la IA primero recupera pasajes relevantes desde un almacén de documentos confiable y luego genera condicionada a esos pasajes. Al anclar la generación en texto verificable, RAG reduce la alucinación extrínseca un 30–60% frente a LLM solo con prompt (Gao et al., 2024).
¿Cómo evita Samio los estándares curriculares alucinados?
Samio recupera estándares oficiales de su propia base antes de cualquier generación, los inyecta como registros estructurados en el prompt y verifica todas las citas contra la fuente de verdad después de generar. Los estándares que no existen en la KB no pueden aparecer en la salida.
¿La IA anclada es lo mismo que «ChatGPT para escuelas»?
No. Un LLM general depende de su corpus de entrenamiento y produce salida confiada incluso sin base factual. Un sistema anclado recupera de una KB autorizada, restringe la salida al contenido verificado y rechaza las citas que no estén en la KB.
¿Puede el grounding eliminar por completo las alucinaciones?
No, pero las reduce sustancialmente y hace que los errores restantes sean visibles y recuperables. Samio combina RAG, bibliotecas de hechos, restricciones de esquema, capas de verificación y revisión humana antes de que ninguna salida llegue a los alumnos.